Creeta — AI 개발자 도구 · 생태계 뉴스
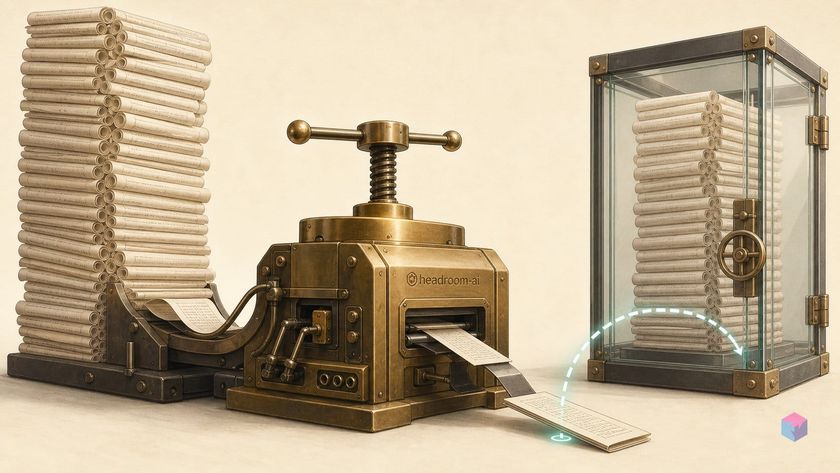
17k 토큰 → 1.4k — Headroom이 원본을 언제든 복원 가능하게 유지
에이전트 파이프라인용 오픈소스 컨텍스트 압축 미들웨어: 토큰 60–95% 절감, CCR 가역성, AST 인식 엔진.
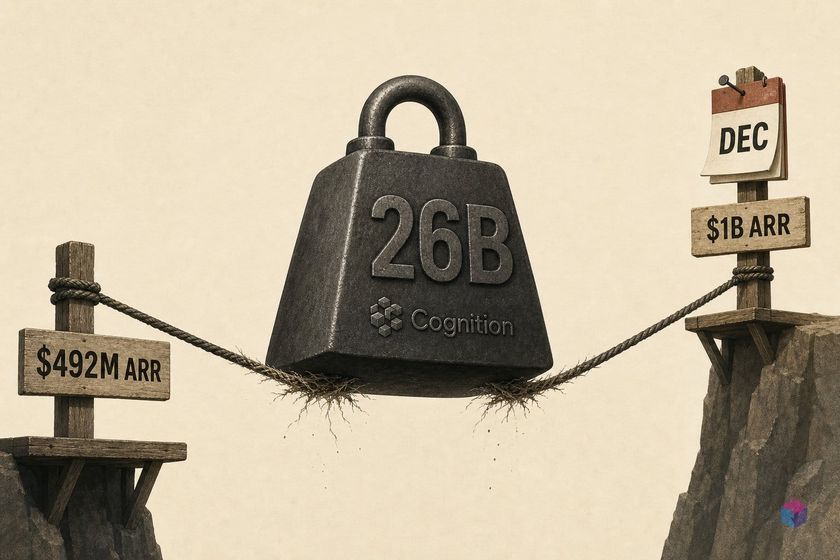
Cognition의 260억 달러, 12월까지 10억 달러 ARR이 필요하다. 수치가 빠듯하다.
4억 9,200만 달러 ARR에 260억 달러 밸류에이션: Cognition 시리즈 D 지표, Windsurf 기여 귀속 문제, 10억 달러 ARR 목표.
졸업식에서 야유를 받다 — 당신이 제품을 만들어야 할 AI 회의론자들
MIT 테크놀로지 리뷰 2026년 5월 과대평가 지수: 졸업식 야유, Z세대 정서(46%), 사상 최고 AI 투자 현황을 다룬다.
Opus 4.8, budget_tokens 폐기 — 그 외 변경 사항 총정리
Opus 4.8: 빠른 모드, 세션 중간 시스템 프롬프트, 1K 캐시 하한. 기존 budget_tokens 구문은 400 오류 반환.
llama-bench, 지원 GPU에서 FA 누락 — b9437로 수정됨
llama.cpp b9437 (5월 30일): llama-bench에서 -fa가 auto로, -ngl이 -1로 변경. b9437 이전 비교 결과는 플래그 검토 필요.
Qwen3.6-35B NVFP4, H100 하나로 구동 — A100 소유자는 제외
FP4 양자화 Qwen3.6-35B는 Hopper에서 약 23GB. vLLM serve 명령어, 환경 변수, DGX Spark 설정 및 주의사항 정리.
Step 3.7 Flash는 드롭인 교체 가능 — 단 하나의 엔드포인트 세부사항 제외
StepFun Step 3.7 Flash: 네이티브 비전과 어드바이저 모드를 갖춘 198B MoE 모델로, OpenAI 호환 API를 즉시 사용 가능. 엔드포인트 주의사항 및 reasoning_effort 예제 포함.
RL 알고리즘은 당신이 고르지 않는다 — SIA의 피드백 루프가 결정한다
SIA는 스캐폴드와 LoRA 가중치를 하나의 루프에서 공동 진화시킵니다. 설치, LawBench 실행, 커스텀 평가 추가까지 — Hexo Labs, 2026년 5월.
NVIDIA, Qwen3.6-35B을 3배 압축했지만 정확도는 거의 그대로
HuggingFace의 NVIDIA NVFP4 Qwen3.6-35B 체크포인트: 메모리 3.06배 절감, 정확도 손실 1% 미만, Blackwell 네이티브 지원, vLLM 플래그 포함.
인증 정보는 Overslash가 보관합니다. AI에게는 핸들만 전달됩니다.
Overslash는 게이트웨이에서 핸들로 시크릿을 주입하고, 에이전트별 영향 범위를 제한하며, 범위를 벗어난 요청은 인간 승인으로 에스컬레이션합니다. 셀프호스팅 무료 또는 좌석당 €3 클라우드.
하네스 수정이 GPU 커널을 10배 느리게 했다. 가중치가 해결했다.
SIA는 스캐폴드를 수정하고 LoRA로 가중치를 파인튜닝한다 — LawBench 70.1%, GPU 커널 12.4% 속도 향상, MIT 라이선스.
Omni는 리렌더링을 건너뛴다 — 9가지 데모로 보는 차이점
Gemini Omni·3.5 Flash 데모 분석: I/O 2026 클립 9개, 장면 보존 vs 병렬 코딩, API 제공 현황.
AI developer tools and ecosystem news for developers and technical founders